

De plus en plus, des discussions et des questions sur les possibilités d’automatisation SEO et AEO via MCP, mais dans le contexte autopilote – c’est a dire, prises de décisions jusqu’a l’éxécution.
Aujourd’hui on va s’intéresser a la stratégie pure, la prise de décision.
La seule chose qu’on demande, c’est que ce soit justifié sur des datas réelles.
D’ailleurs, c’est une question qu’on s’est posée aussi, en tant qu’agence SEO à Montréal, depuis 2 ans. Automatiser tout ce qui peut l’être, de manière juste, c’est-à-dire basé sur les données – est quelque chose qu’on ne se priverait pas d’utiliser et d’exploiter – c’est l’objet de notre projet Prediict.
Maintenant, il faut se demander dans quelle mesure c’est possible, si nos données sont lourdes – et elles le sont pour vous aussi, vous pouvez nous croire.
Éviter les trous de l’IA – Magiciens et enfance
On a tous été fasciné, à un moment ou à un autre, par les magiciens ou les formules magiques. Abracadabra et hop, – étincelles dans les yeux : une solution apparente à un problème complexe.
Puis vient l’âge adulte….A priori.
Depuis le début du mois j’ai eu au moins 5 discussions différentes avec des clients me demandant un avis sur l’automatisation de certaines parties de SEO on-site en autopilote via MCP. Tous, en charge de site de plusieurs centaines ou milliers de pages et avec un bon trafic, bien réparti – détail d’importance.
Puis, mon chat m’envoie cet article : https://hackernoon.com/i-stopped-asking-ai-for-seo-ideas-and-started-feeding-it-search-console-data-instead
Vous voyez le parallèle ?
Je suis pareil, j’aimerai automatiser ma comptabilité complètement, mon marketing , mes backlinks, mes hacks, mes suivis, les refontes, mes maigres réseaux sociaux et ce qui est posté dessus, ce que j’envoie comme emails aux clients, et tout ce qui prends du temps et de l’argent.
Sur le principe, en SEO / AEO pur, ca se teste de plusieurs manière.
MCP et projet magique typique :
- Le client (Host app) : C’est l’application d’IA qu’on utilise au quotidien.
- Le serveur MCP : C’est le pont qui fait l’intermédiaire…
- Les data, outils et prompts : Ce sont les éléments externes (datasets, fichiers, recherches web, commandes) auxquels l’intelligence artificielle peut enfin accéder directement et proprement.
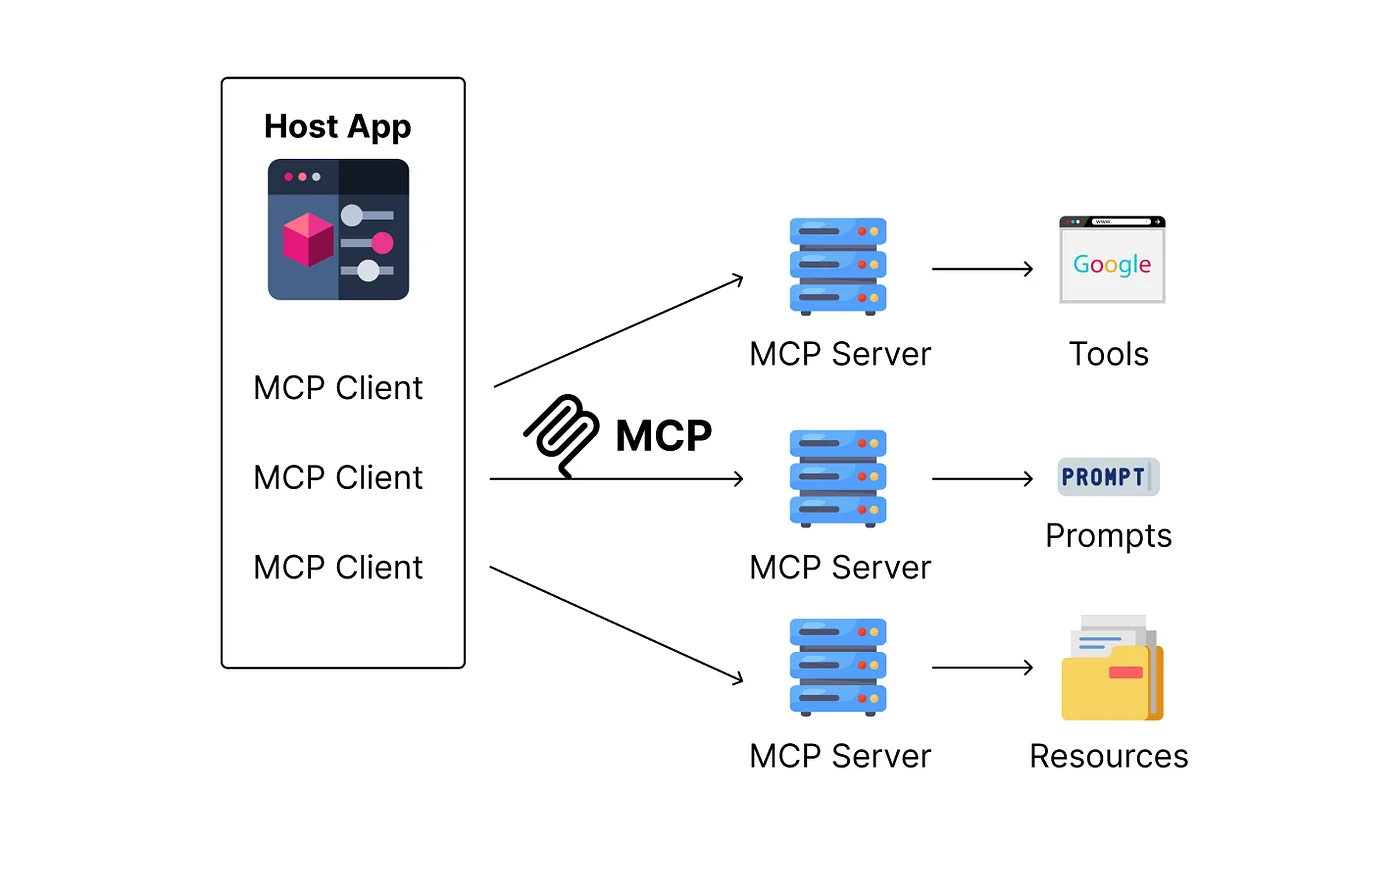
Réalité du SEO et AEO : de LARGES data sets.
Sur combien de lignes cette réponse a-t-elle été produite, et qui a choisi lesquelles ?
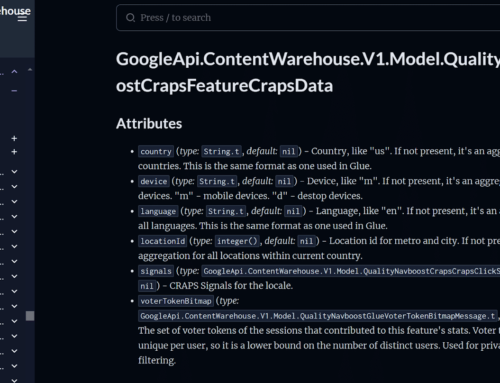
Alors rentrons dans le dur. La documentation de l’API Search Analytics contient une phrase que peu de gens lisent avant de brancher leur outil d’IA.
Google y précise que l’API ne garantit pas de renvoyer toutes les lignes de données, seulement celles du haut. Tout est là. Les données Search Console que vous confiez à un modèle de langage sont déjà triées, filtrées et plafonnées avant la première ligne d’analyse.
Depuis quelques mois, les tutoriels se multiplient : on relie la Search Console à ChatGPT ou à Claude par un connecteur MCP, on programme une tâche quotidienne, et l’IA surveille le site. Le dernier en date, publié sur HackerNoon le 3 octobre 2026, est d’ailleurs prudent et bien construit.
Mais c’est un site vitrine et il porte sur une durée de 25 jours.
À cette taille, n’importe quelle méthode semble fonctionner.
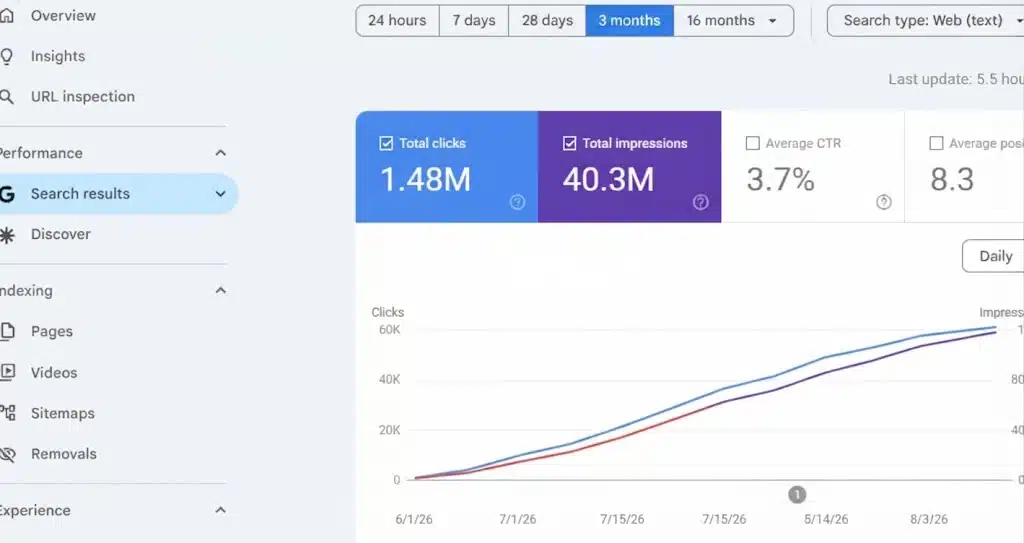
Nous travaillons sur des sites qui ont des milliers de pages et des centaines de milliers de requêtes.
D’ailleurs votre site est, selon toute vraisemblance, plus gros que celui de l’article. Sur 12 mois, l’ensemble de vos queries, ou page, avec clics, impressions, CTR et rankings (la BASE pour analyser correctement) , ça représente beaucoup de volume de donnée.
Nous avons aussi construit notre propre application d’analyse GSC, et nous l’avons cassée plusieurs fois.
Et donc… voici ce que nous avons appris, illusion par illusion.
La fenêtre de contexte, LA limite
Avant toute chose ; la fenêtre de contexte correspond à la quantité maximale de texte qu’un modèle peut traiter en une seule fois : la question, les instructions, les données transmises et la réponse elle-même.
Selon les modèles, elle va de 200 000 à 1 million de tokens, ce qui paraît énorme jusqu’à ce qu’on y verse des données Search Console.
Denses, chiffrées et répétitives, elles se découpent en moins de 3 caractères par token, si bien qu’une seule année de requêtes et de pages d’un site de taille moyenne suffit à saturer la fenêtre la plus large. Au-delà, il n’y a pas de débordement visible : les données sont tronquées en amont, ou le modèle répond avec ce qu’il a pu charger.
Même sous ce plafond, la lecture n’est pas uniforme. Des travaux de recherche ont montré que les modèles exploitent mieux l’information placée au début et à la fin d’un long contexte que celle située au milieu.. BREF, un phénomène baptisé lost in the middle … Donc, remplir la fenêtre ne garantit donc pas que tout soit lu avec la même attention. C’est pourquoi le MCP ne règle rien…
Vos données Search Console sont déjà triées avant l’IA
Illusion n° 1 : L’IA a accès à toutes mes données
Faux à trois niveaux. D’abord, Google exclut les requêtes dites anonymisées, trop rares pour être affichées sans risque pour la vie privée. Elles disparaissent dès qu’on ventile par requête ou qu’on applique un filtre. Ensuite, l’export de l’interface s’arrête à 1 000 lignes, et l’API à 50 000 lignes par jour, par site et par type de recherche, récupérables par tranches de 25 000. Enfin, comme le rappelle la documentation citée plus haut, ce que l’API renvoie, ce sont les lignes du haut. Sur un site avec du contenu, ou sur un e-commerce à forte longue traîne, la partie moins visible n’est pas un détail : c’est là que se trouvent les opportunités.
Illusion n° 2 : Une impression est une impression
Pas dans Search Console. Les règles d’agrégation par propriété ou par page changent le sens des chiffres. Le graphique agrège par propriété : si deux de vos pages apparaissent sur la même page de résultats, cela compte pour une seule impression, et seule la position la plus haute est retenue. Le tableau par page, lui, compte chaque URL séparément. Résultat : le CTR et la position moyenne sont généralement meilleurs au niveau de la propriété dès que plusieurs pages se cannibalisent.
Un modèle de langage qui additionne des lignes de tableau pour les comparer au total du graphique produira un écart. Puis il l’expliquera, avec aplomb, par une cause inventée.
Nous l’avons vu faire.
Le contexte, angle mort de toute automatisation
Illusion n° 3 : Le MCP donne accès, donc l’IA lit tout
Un connecteur MCP n’ouvre pas une base de données au modèle. Il lui renvoie un résultat textuel, qui doit tenir dans sa fenêtre de contexte. La documentation du connecteur GSC de Pipedream est l’une des rares à le dire clairement : rester sous 200 lignes par appel, sachant que 100 lignes pèsent environ 13 000 caractères et qu’au-delà de 400 lignes la réponse déborde.
L’équipe de Brex a publié un calcul encore plus parlant, appliqué aux dépenses d’entreprise : une fenêtre de 200 000 tokens contient environ 500 lignes, une fenêtre d’un million en contient 3 000 à 4 000.
Vous rendez-vous compte de ce que cela implique sur une analyse à 4 métriques sur 2 dimensions ? Je rappelle que REQUÊTES + PAGES avec CLICS, IMPRESSIONS, CTR et RANKING est le minimum vital.
Au-delà, écrivent-ils, le modèle cesse de lire sans le signaler et répond avec ce qu’il a. Leur solution est instructive. Les données sont chargées dans une base temporaire, interrogées en SQL, et seul un résultat d’une dizaine de lignes entre dans le contexte. Le modèle ne lit plus les données. Il lit la réponse à une requête précise.
Illusion n° 4 : Un RAG seul résout le problème
C’est la première chose que nous avons crue. Prediict collecte encore via l’API et le branchement sur l’export BigQuery est la prochaine étape. Donc brièvement, la version initiale de Prediict, notre application d’analyse branchée sur Search Console, découpait les données en blocs, les vectorisait dans Supabase, et un agent ne récupérait que les blocs les plus pertinents pour chaque question. Sur une question bornée, du type mots-clés ayant progressé en août au Canada, le résultat était bon.
Sur une tendance annuelle, il était faux. Une recherche vectorielle remonte les passages sémantiquement proches de la question. Pas tous les passages. Demandez une évolution sur 12 mois, vous obtiendrez une analyse construite sur quelques mois choisis par similarité. Le RAG n’a pas supprimé l’échantillonnage … Autrement dit, une question sur dix pouvait être traitée avec la mauvaise stratégie, sans que l’utilisateur le sache.
Les données GSC sont denses : moins de 3 caractères par token, ce qui a fait sauter nos premiers plafonds calculés en caractères.
Sans ces données, on devine, on divague, on est dans l’ésotérisme….
Donc MCP+RAG= un peu… mais guère mieux qu’un copier-coller de vos exports dans chatGPT . Pas suffisant pour une vraie proposition SEO.
Ce qu’un modèle de langage ne fera jamais à notre place
Illusion n° 5 : L’IA calcule les variations
Elle ne calcule pas, elle lit et elle reformule. Isoler les requêtes apparues ce mois-ci, mesurer l’écart de clics entre deux périodes, filtrer les pages en positions 11 à 20 avec beaucoup d’impressions : ce sont des jointures, des différences, des filtres. Une requête SQL les exécute à l’identique mille fois de suite. Un modèle de langage, interrogé deux fois sur les mêmes données, peut produire deux listes différentes. Pour un rapport client, c’est un problème. Pour une décision de refonte, ou de strat web, c’est une faute.
Illusion n° 6 : L’automatisation garde la mémoire des tests
Une boucle d’expérimentation suppose un historique : quelle page a été modifiée, quand, sur quel élément, avec quelle situation de départ. Une tâche planifiée qui démarre chaque matin sans état persistant ne possède rien de tout cela. Nos propres spécifications prévoyaient des tables dédiées aux conversations, aux messages et aux résumés, précisément parce qu’aucun modèle ne retient quoi que ce soit d’une session à l’autre. Sans journal des changements tenu hors du modèle, on n’expérimente pas. On commente.
Illusion n° 7 : Si ça monte après le changement, c’est grâce au changement
C’est la plus coûteuse. Un site neuf voit Google tester ses pages sur des requêtes de niche dans les premières semaines, quoi qu’on fasse. Un site saisonnier monte et descend avec son marché. Une mise à jour d’algorithme déplace tout le monde en même temps. Cinq impressions en position 6 ne prouvent rien, et une hausse de 15 % sur trois semaines non plus, si l’on ne dispose ni d’une comparaison d’une année sur l’autre ni de pages témoins laissées intactes. Un modèle de langage ne refusera jamais de conclure. Il faut le lui interdire.
Quatre architectures, quatre niveaux de vérité
Toutes les solutions « IA + Search Console » ne se valent pas. La vraie question n’est pas quel modèle elles utilisent, mais ce que ce modèle voit réellement au moment de répondre.
| Architecture | Ce que le modèle voit | Questions adaptées | Risque principal | Notre verdict |
| MCP direct sur l’API | Quelques centaines de lignes, les premières renvoyées | Questions ponctuelles sur un petit site | Troncature silencieuse | Utile pour explorer, jamais pour décider |
| RAG vectoriel | Les blocs jugés proches de la question | Période ou page précise | Échantillonnage invisible sur les tendances | Bon assistant, mauvais analyste |
| Lecture exhaustive par lots | Tout, mais résumé lot par lot | Tendances, synthèses globales | Erreurs cumulées dans les résumés intermédiaires | Correct si contrôlé par SQL |
| Pipeline SQL puis modèle | Un résultat déjà calculé et réduit | Toutes, y compris sur de gros volumes | Dépend de la qualité des requêtes écrites | La seule option fiable à grande échelle |
| Routage automatique entre stratégies | Variable selon la décision du routeur | Usage grand public | Une mauvaise stratégie choisie sans prévenir | À journaliser systématiquement |
Le constat est simple. Plus le modèle intervient tôt dans la chaîne, plus la réponse dépend de ce qu’il a eu le hasard de lire.
Plus il intervient tard, plus il fait ce qu’il fait bien : EXÉCUTER et, pourquoi pas, nous aider a traiter ou interpréter certaines choses.
C’est clairement la direction que nous prenons.
Analyser les données Search Console sans se mentir
Notre méthode tient en quelques principes, appliqués différemment selon les sites. La donnée brute d’abord : l’export groupé de Search Console vers BigQuery livre chaque jour deux tables, l’une agrégée par propriété, l’autre par URL, sans le plafond de lignes de l’API. Les requêtes anonymisées n’y sont pas supprimées mais regroupées dans des lignes identifiées par un indicateur dédié, ce qui permet au moins de mesurer la part d’ombre.
Les calculs ensuite, en SQL : différences entre périodes, seuils minimaux d’impressions avant toute conclusion, comparaison d’une année sur l’autre pour les marchés saisonniers. Le journal des changements, tenu à part et horodaté. Et le modèle de langage en dernier, sur des résultats déjà calculés, avec une consigne explicite : signaler toute donnée manquante plutôt que de la combler.
Ces principes ne s’appliquent pas de la même manière partout. Sur un éditeur SaaS bilingue comme eZsign, réparti sur plusieurs domaines et dont le crawl révèle des milliers d’URL paramétrées par des outils tiers, la première étape consiste à nettoyer et segmenter, faute de quoi le bruit domine tout le reste. Chez Innovation Solaire Québec, avec une boutique principale et des sites régionaux aux volumes modestes, l’enjeu est inverse : éviter les conclusions sur des échantillons trop minces et lire chaque variation à l’aune de la région et de la saison.
C’est ce travail de cadrage, plus que l’outil, qui fait la valeur d’une analyse SEO fondée sur la donnée réelle.
Reste une question que nous posons désormais à chaque prestataire, chaque démonstration d’outil, chaque tutoriel enthousiaste.
Sur combien de lignes cette réponse a-t-elle été produite, et qui a choisi lesquelles ?
À mon avis, tant que personne ne sait y répondre, ce n’est pas une analyse. C’est un texte bien écrit sur une partie de vos données.
L’expérience décide – l’IA exécute
Même avec l’ensemble des données réellement lues, calculées et vérifiées, une IA ne fait pas une stratégie SEO. Elle exécute des tâches, et tout l’enjeu est de savoir lesquelles lui confier, dans quel ordre, sur quel périmètre de données et avec quelle limite de conclusion. Ce découpage ne s’improvise pas : il demande le discernement de quelqu’un qui a déjà vu des sites monter, chuter et se relever, et qui sait reconnaître une cannibalisation, une saisonnalité ou un faux signal avant que le modèle ne les transforme en certitudes. Quelques heures de cadrage humain suffisent à orienter des semaines de travail automatisé….
Cela prend relativement peu de temps mais bon, un peu plus qu’une formule magique….
FAQ
Peut-on faire du SEO prédictif ou un calendrier éditorial avec un échantillon de données Search Console ?
Non. Une projection de trafic, une analyse de saisonnalité ou un calendrier éditorial calé sur les pics de demande reposent sur l’historique complet : toutes les requêtes et toutes les pages, sur 12 à 16 mois au minimum, avec clics, impressions, CTR et positions. Sur un extrait, le modèle ne voit ni les cycles annuels, ni les requêtes de longue traîne qui émergent, ni les pages qui déclinent lentement. Il projette alors une tendance qui n’existe que dans les lignes qu’on lui a transmises. Pour prédire, il faut tout et même, ce n’est pas assez :)
Pourquoi les données Search Console de l’API diffèrent-elles de l’interface ?
Parce que les deux n’agrègent pas toujours de la même façon (par propriété ou par page), que les requêtes anonymisées disparaissent dès qu’un filtre est appliqué, et que l’API ne garantit que les lignes du haut, dans la limite de 50 000 par jour.
Peut-on faire confiance à ChatGPT ou Claude pour analyser la Search Console ?
Pour calculer lui-même des variations sur des milliers de lignes, non : il lit un extrait, ne le signale pas toujours, et ses réponses varient d’une exécution à l’autre.
Quelle est la différence entre un MCP et un RAG pour l’analyse SEO ?
Le MCP transmet au modèle le résultat d’un appel d’outil, limité par la fenêtre de contexte. Le RAG sélectionne les passages les plus proches de la question dans une base vectorielle. Aucun des deux ne garantit une lecture complète des données.
Faut-il passer par BigQuery pour analyser un gros site ?
Dès que le site dépasse quelques centaines ou milliers de pages ou que la longue traîne pèse un minimum, c’est la voie la plus sûre : pas de plafond de lignes, historique conservé et calculs reproductibles en SQL….C’est quelque chose sur lequel nous reviendrons car notre méthodologie prediict en est issue ; analyse complète, suivi de division contrôlée des tâches.

Ecrire un commentaire